
ローカルLLMとは?クラウドLLMとの違い・活用例・必要なサーバースペックを解説
ローカルLLMとは、クラウド上のAIサービスを利用するのではなく、自社サーバーや端末などのローカル環境で大規模言語モデルを動かす仕組みです。データを自社環境内で処理しやすい一方、利用するモデルに応じたGPU・VRAM・メモリなどのサーバースペックが必要になります。
クラウドLLMと比べて、セキュリティやカスタマイズ性に優れる反面、初期費用や運用負荷がかかる点には注意が必要です。
本記事では、ローカルLLMの仕組みやクラウドLLMとの違い、代表的なモデル、活用シーン、必要なサーバースペック、導入ステップまで解説します。
目次
ローカルLLMとは?クラウドAIとの違い
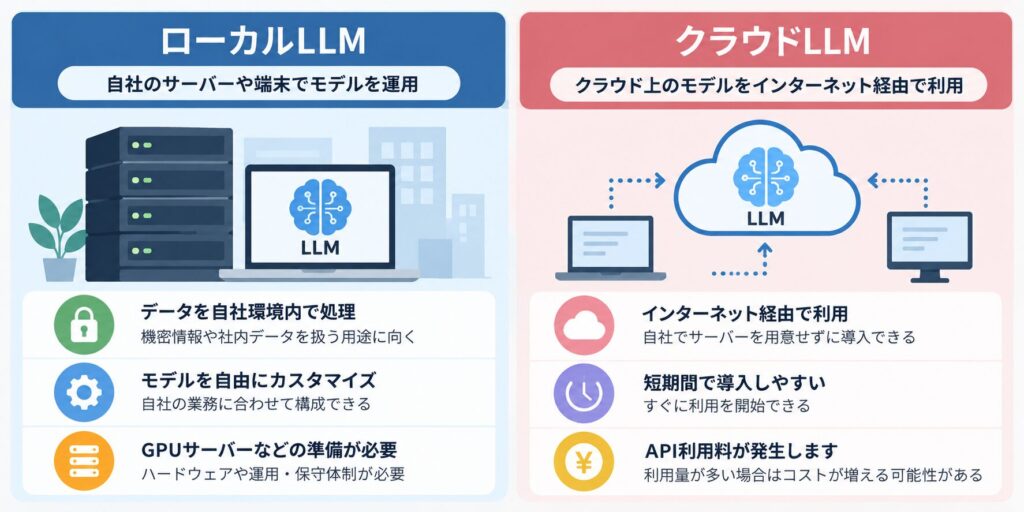
ここでは「ローカルLLMとは何か/クラウド型AIとの違い」について整理していきます。
ローカルLLMの基本的な仕組みと定義
ローカルLLMは、機密情報の外部流出リスクを抑えやすく、クラウドサービスへのデータ送信を避けたい業務に適しています。
また、クラウドサービスの利用料を抑えられる可能性がある一方、モデルの実行に必要なサーバーやGPUなどの設備投資、運用・保守のコストが発生します。
導入にあたっては、セキュリティ要件や利用規模、運用体制を踏まえ、クラウド型LLMと比較検討することが重要です。
クラウド型LLM(API提供型AI)との違い
クラウド型LLMは、外部クラウドプロバイダーのインフラ上に設置されたモデルに対して、ユーザー側がデータを送信して応答を受け取る仕組みを採用しています。
導入が迅速で、インフラ管理の負荷が少ないという大きな利点がありますが、データがネットワーク経由で外部に移動するため、通信遅延や外部サービスへの依存、情報漏洩というリスクが伴うでしょう。
さらに、利用量に応じた料金が継続的に発生しやすく、長期運用ではコストが膨らむ可能性があります。また、モデルのカスタマイズ自由度や細部制御において制限があるケースも見られます。
こうした観点から、「データ処理の流れ」「コスト構造」「カスタマイズ・管理体制」といった観点では、クラウド型とローカル型とで明確な違いがあるため、自社の目的や状況に応じて適切な方式を判断する必要があります。
ローカルLLMで使われる代表的なモデル
ローカルLLMでは、Gemma、Qwen、gpt-oss、Llamaなどのモデルが利用されています。
モデルごとに規模や得意分野、必要なGPU・VRAMが異なるため、用途とサーバー環境に合わせて選ぶことが重要です。
| モデル | 開発元 | 主な特徴 | サーバー選定時のポイント |
|---|---|---|---|
| Gemma | 小型でも高性能で画像入力にも対応 | 小規模モデルは比較的少ないGPUメモリでも検証しやすい | |
| Qwen | Alibaba | 小規模から大規模までラインアップが豊富 | モデル規模によって必要なGPU構成が大きく変わる |
| gpt-oss | OpenAI | 自社環境で利用できるオープンウェイトモデル | 20Bは16GBメモリ、120Bは80GBメモリクラスのGPUが必要 |
| Llama | Meta | ローカルLLMで広く利用されるモデル群 | 大規模モデルでは複数GPU構成が必要になる場合がある |
Gemma
GemmaはGoogleが提供するオープンモデルです。
小規模から中規模まで複数のモデルがあり、ローカル環境での検証にも利用しやすい特徴があります。
利用するモデルサイズによって必要なGPU性能は異なるため、用途に合わせたサーバー選定が必要です。
Qwen
QwenはAlibabaが開発するLLMシリーズです。
小規模モデルから大規模モデルまで幅広く、検証用途から本格的なAI基盤まで利用できます。
モデル規模が大きくなるほど、GPUメモリや複数GPU構成の検討が必要です。
gpt-oss
gpt-ossはOpenAIが公開しているオープンウェイトモデルです。
gpt-oss-20bとgpt-oss-120bがあり、モデル規模によって必要なメモリ容量が大きく異なります。
そのため、使用するモデルを決めたうえでGPU・メモリ構成を設計する必要があります。
Llama
LlamaはMetaが提供するLLMシリーズです。
ローカルLLMや企業向けAI基盤で広く利用されており、大規模モデルでは複数GPUや大容量VRAMが必要になる場合があります。
モデルに合わせたサーバー構成が必要
必要なサーバースペックは、モデルの種類だけでなく以下の条件でも変わります。
- パラメータ数
- 量子化の有無
- コンテキスト長
- 同時利用者数
- 推論速度
- RAGなどの連携有無
そのため、ローカルLLMでは、利用目的とモデル規模に合わせてGPU・メモリ・ストレージなどを設計することが重要です。
ローカルLLMを導入するメリット
ここでは、「ローカルLLMを導入する際に得られる主なメリット」について解説します。
セキュリティ・プライバシーを自社で完結できる
ローカルLLMを使うことで、重要な社内データがクラウドを経由して外部に出ることがなく、自社インフラ内で完結できる安心感があります。例えば、外部APIを介した処理では、通信路やクラウド側のログ保存がデータ流出リスクを高めると指摘されているのが現状です。
一方、社内環境で運用すれば、アクセス制御やログ監査などコンプライアンス対応を自ら設計・運用できるため、「誰が・どこで・何を扱ったか」を明確にする記録管理も容易です。これは特に、金融・医療・公共分野など機密情報を扱う組織にとって重要な意味を持ちます。
長期的に見れば、クラウドサービスの利用時に発生し得る契約外のデータ活用やサービス停止リスクも低減でき、自社主体のセキュリティ体制を築くうえで有効な選択肢です。
オフライン動作・レイテンシ低減による安定性
ローカル環境でLLMを運用する強みのひとつに、ネットワーク依存が少ないことが挙げられます。典型的には、クラウド経由では通信遅延や回線障害による処理遅延・停止の可能性がついて回ります。
しかし、社内サーバーまたは端末上でモデルを動かすローカルLLMでは、データの往復を伴わずに即時応答を得られやすいため、リアルタイム性が求められるユースケースにおいて優位性があるでしょう。
また、インターネット接続が不安定な環境や完全にネットワーク分離されたHVC(ハイセキュリティ)環境でも、自社内で完結できるため、業務継続性の確保という観点でも信頼性が高まります。
カスタマイズ性と社内データ活用の柔軟性
ローカルLLMを採用すると、社内固有のデータや業務プロセスに最適化したモデル構築が可能になります。クラウド提供のモデルでは「API仕様」「提供モデルの選択肢」「プロバイダー制約」によって細部のカスタマイズが制限されることが多く、実業務特化型のチューニングが難しい場合もあるでしょう。
一方で、社内サーバー上でオープンソースモデルをファインチューニングすることで、専用用語・社内コード・顧客対応履歴といった固有データを反映したAIを構築できます。
その結果、「自社のみが持つナレッジを活用できる」「他社と差別化された応答が可能になる」といったメリットが得られます。さらに、モデルの更新や運用ポリシーも自ら設定できるため、長期的には競争力を維持しやすくなるといえるでしょう。
ローカルLLM導入におけるデメリット
ここでは、ローカルLLMを導入する際に企業が直面しやすい「コスト・運用・体制面での課題」について整理します。
高スペックなサーバー・GPU環境が必要
ローカルLLMを実行するには、モデルの規模に応じた高性能GPUや十分なメモリ容量を備えたサーバー環境が必要です。
例えば、数十億パラメータ規模のモデルでもVRAMが20〜40GB以上、場合によっては複数GPU構成が求められます。さらに、長時間の連続稼働を想定した電源・冷却設備、SSDストレージ、ネットワーク帯域などのインフラ整備も欠かせません。
こうした要件は企業規模や利用頻度によっては相応の初期投資負担となり、個人や中小規模の組織では導入ハードルが高くなりがちです。また、GPU市場では価格変動が激しく、長期的な運用コストを見誤ると費用対効果が低下するリスクもあります。
運用・アップデート・モデル管理の負担
ローカルLLMは導入後の維持・管理を自社で行う必要があります。クラウド型であれば自動的に更新や最適化が行われますが、ローカル運用ではライブラリやドライバの更新、セキュリティパッチ適用、モデルの最適化・再学習などを自社の技術チームが担当しなければなりません。
また、運用中に発生するメモリ不足・GPUトラブル・温度上昇などの障害対応もすべて社内リソースで解決する必要があります。さらに、新しいモデルが登場した際には検証や切り替え作業も発生するため、AI運用を継続的に行う体制を整えることが重要です。
こうしたメンテナンス負荷は、長期的に見ればクラウド型よりも人件費・時間的コストが増加する要因となります。
開発・検証環境の整備コスト
ローカルLLMの効果を最大限に引き出すには、モデルのチューニングや検証を行うための環境構築が欠かせません。
例えば、トレーニング用データの準備、評価指標の設計、性能比較の自動化など、AI開発特有の工程を担う人材とツールが必要です。社内にAIやMLOpsの知見を持つエンジニアがいない場合、採用や教育のコストも発生します。
さらに、モデルの安全性検証やデータ管理ルール策定など、導入初期に検討すべき項目も多岐にわたります。そのため、単にサーバーを用意するだけでは十分ではなく、開発体制全体を設計する初期段階での負荷が大きい点がローカルLLM導入の大きな課題といえるでしょう。
ローカルLLMの活用シーン
ローカルLLMは、社内データや機密情報を扱う業務を中心に、さまざまな用途で活用できます。代表的な活用シーンを紹介します。
社内文書・ナレッジの検索
社内規程、業務マニュアル、FAQ、製品仕様書、議事録などをRAGと連携し、必要な情報を自然言語で検索できます。
社内に蓄積された情報を探しやすくなり、問い合わせ対応や情報共有の効率化につながります。
契約書・報告書などの文書処理
契約書の重要項目の抽出、文書の要約、表記ゆれの確認、過去文書との比較などに活用できます。
法務、総務、経理など、機密性の高い文書を扱う部門でも、自社環境内で処理しやすい点がメリットです。
カスタマーサポート・社内問い合わせ対応
FAQやマニュアル、過去の問い合わせ履歴をもとに、回答案の作成や問い合わせ内容の分類に活用できます。
顧客情報や社内情報を扱う場合でも、データを自社管理の環境内で処理できます。
製造業・研究開発での技術情報活用
設計資料、技術仕様書、設備マニュアル、保守履歴、研究資料などの検索・要約に活用できます。
工場や研究施設など、外部ネットワークへの接続が制限される環境でも、ローカル環境にAI基盤を構築できます。
ソフトウェア開発・システム運用の支援
ソースコード、仕様書、設計書、障害対応履歴などを参照し、コード生成、レビュー補助、調査、テスト項目の整理に活用できます。
社内コードやシステム情報を外部サービスへ送信しにくい企業でも、開発支援AIを導入しやすくなります。
金融・法務など機密性の高い業務
金融機関では社内規程や商品情報、法務部門では契約書や過去の文書など、外部に出しにくい情報の検索・整理に活用できます。
アクセス権限やネットワーク構成を自社要件に合わせて設計できるため、情報管理を重視する業務と相性があります。
オフライン・閉域環境での利用
インターネット接続が難しい工場、研究施設、データセンターなどでも、ローカルLLMであれば自社ネットワーク内で利用できます。
外部APIへの接続に依存せず生成AIを利用したい環境で有効です。
ローカルLLMとクラウドLLMはどちらを選ぶ?
ローカルLLMとクラウドLLMは、セキュリティ、コスト、運用体制、利用量で選びます。
ローカルLLMが向いているケース
- 機密情報や社内データを外部に送信したくない
- オンプレミスや閉域環境で利用したい
- RAGで社内データを活用したい
- モデルやシステムを自社向けに構成したい
- LLMを継続的・大規模に利用する
データ管理やカスタマイズ性を重視する場合は、ローカルLLMが適しています。
クラウドLLMが向いているケース
- 小規模から生成AIを試したい
- GPUサーバーを自社で管理したくない
- 短期間で導入したい
- 利用量が少ない、または変動が大きい
- インフラ運用の負担を抑えたい
初期費用を抑えて導入したい場合は、クラウドLLMが適しています。
選定時に比較するポイント
選定時は、以下を比較します。
- データの機密性
- 利用量・同時利用数
- 必要な処理性能
- 初期費用・運用コスト
- 運用体制
- 将来の拡張性
用途によっては、機密性の高い処理をローカルLLM、それ以外をクラウドLLMで行う併用も有効です。
ローカルLLMを動かすためのサーバースペック要件
ローカルLLMを安定的に運用するためには、GPUをはじめとするハードウェア構成の最適化が欠かせません。ここでは「GPUの選び方」「周辺スペックの設計」「インフラ環境の最適化」という3つの観点から、必要なサーバー構成の考え方を整理します。
GPU選定のポイント(VRAM容量・世代・構成)
ローカルLLMの性能を左右する最大の要素がGPUです。モデルのパラメータ数が大きくなるほど必要なVRAM(GPUメモリ)も増加します。
近年では、FP4などの量子化技術の進化により、必要とされるVRAMの目安が大きく変わっています。例えば、7Bクラスのモデルであれば10GB〜16GB、より大規模な70Bクラスのモデルであっても、量子化を適用することで50GB前後のVRAMで動作させることが可能です。高精度(FP16)での推論や、より大きなモデルを扱う場合、あるいは学習(ファインチューニング)を行う場合は、VRAM使用量が増えるため、依然として80GB以上のVRAMや、複数GPUを組み合わせた構成を検討するケースもあるでしょう。
GPUを選定する際は、「VRAM容量」「帯域幅」「世代(アーキテクチャ)」「消費電力」のバランスを考慮することが重要です。
例えば、NVIDIA B300やB200は大規模モデルの学習・推論に適しており、一方でRTX PRO 6000 BlackwellやRTX PRO 4500 Blackwellは中規模モデルの開発・社内検証用途に向いています。コストと性能のバランスを見極め、自社で扱うモデル規模に合わせた選定が必要です。
※GPUサーバー一覧のリンクカードを挿入
メモリ・CPU・ストレージなど周辺スペック
GPUの性能を最大限に引き出すには、周辺スペックの整合性が不可欠です。メインメモリ(RAM)は最低でも32GB、理想的には64GB〜128GB程度を確保すると安定した推論が可能になります。
CPUはマルチスレッド処理に優れた高クロックタイプを選ぶとよく、特にGPUとのデータ転送を効率化するためにPCIe帯域の広い構成が望まれます。ストレージは読み込み速度が重要で、NVMe SSDを採用することでモデルのロード時間やキャッシュ処理を大幅に短縮可能です。
HDDよりも高価ではありますが、実運用ではパフォーマンス面での効果が大きいため、コストをかける価値があります。これらの要素をGPU性能に見合うように設計することが、ボトルネックのない安定したAI処理を実現する鍵です。
冷却・電源・ネットワーク設計の最適化
ローカルLLMの運用は、GPUやCPUに高負荷が継続的にかかるため、サーバーインフラ全体の設計にも注意が必要です。特に冷却は最重要項目です。
GPUを複数枚搭載した環境では発熱量が非常に大きく、適切な空冷や液冷システムを導入しないと、熱暴走による性能低下や停止が発生します。
また、電源はGPU構成に合わせて十分な容量を確保する必要があり、定格出力に20〜30%の余裕を持たせるのが理想です。さらに、停電や電圧変動に備えてUPS(無停電電源装置)を導入すると、安定稼働を維持しやすくなります。
ネットワーク面では、複数サーバーでモデルを分散実行する場合や社内システムと連携させる際に、高速かつ安定した通信が求められます。10GbE以上の帯域を確保し、可能であれば専用ネットワークを設けることで、データ転送の遅延を防げるでしょう。
ローカルLLMの導入流れ
ローカルLLMは、要件整理からPoC、本番展開まで段階的に進めます。
1. 目的と要件を明確にする
まず、ローカルLLMを導入する目的を整理します。
社内文書検索、問い合わせ対応、文書要約、開発支援など、対象業務によって必要なモデルやシステム構成は変わります。
あわせて、利用者数、扱うデータ、セキュリティ要件、必要な応答速度、予算、運用体制も確認します。
2. モデルと実行環境を選定する
用途に合ったLLMと、それを動かすGPUサーバーや実行環境を選定します。
モデル規模、必要なGPU・VRAM、処理速度、ライセンス条件などを確認し、必要に応じてRAGや社内システムとの連携も検討します。
3. PoCを実施する
本番導入前に、限定した業務やデータでPoCを行います。
回答精度、推論速度、安定性、GPU使用率などを確認し、実際の業務で使えるかを検証します。
RAGを利用する場合は、検索精度や参照元の表示も確認します。
4. 本番環境へ段階的に展開する
PoCで効果を確認したら、本番環境を構築します。
まずは対象業務や利用部門を限定して運用し、利用状況を見ながら段階的に拡大します。
運用開始後も、モデル更新、利用量の増加、GPU負荷などを確認し、必要に応じてサーバー構成や運用方法を見直します。
ローカルLLM導入時の注意点
ローカルLLMでは、モデルだけでなく、実際の利用条件や将来の拡張性を考えて環境を設計することが重要です。
モデル性能だけでGPUを選ばない
GPUは、モデルの性能だけでなく、用途や処理量に合わせて選定します。
モデル規模、量子化方式、必要な推論速度、同時処理数などによって、必要なGPUやVRAMは変わります。
同時リクエスト数やコンテキスト長も考慮する
必要なGPUメモリは、モデルサイズだけでは決まりません。
同時リクエスト数やコンテキスト長が増えると、必要なGPUメモリや処理性能も増えます。
将来的な拡張性を考える
将来的に利用モデルの変更や利用量の増加が発生する可能性があります。
GPU増設の可否や電源容量、冷却性能、ネットワーク帯域なども確認し、拡張しやすい構成にしておくことが重要です。
ローカルLLMの導入に関するよくある質問
ローカルLLMの導入前に、実際の環境で性能を検証できますか?
はい。トゥモロー・ネットでは導入前検証サービスを提供しており、用途や環境に合わせて構成を検討できます。実際のワークロードを想定して性能や安定性を確認してから、本番環境の構成を決めることが可能です。
既存のサーバーやインフラを活かしてローカルLLMを構築できますか?
既存環境を活用できる場合があります。トゥモロー・ネットでは、現在利用しているインフラも確認したうえで、GPUサーバー、ストレージ、ネットワークなどを含めた構成を提案しています。
ローカルLLMとRAGを組み合わせた環境についても相談できますか?
はい。トゥモロー・ネットでは、GPUサーバー上にローカルLLMとRAGを構築する技術検証を行っています。社内文書や独自データを活用したAI環境についても相談できます。
まとめ
ローカルLLMは、クラウドに依存せず自社の環境で大規模言語モデルを稼働させることで、セキュリティ・独立性・カスタマイズ性を高められる次世代のAI活用基盤です。
特に、機密情報を扱う企業や、高速応答・安定稼働が求められる現場では、その価値が一層際立ちます。
一方で、ローカルLLMの性能を最大限に引き出すには、高性能GPUや十分なメモリ、高速ストレージ、安定した冷却・電源・ネットワーク環境といった総合的なシステム設計が欠かせません。
単にハードウェアを導入するだけでなく、AIワークロードに最適化されたサーバー構成を設計することが、継続的な運用とコスト効率の両立に直結します。
株式会社トゥモロー・ネットでは、こうしたAI基盤の設計から構築・運用支援までを一貫して提供しています。
NVIDIA B300やRTX PRO 6000 Blackwellなど最新GPUを搭載したサーバーや、堅牢なストレージ、低遅延ネットワークを組み合わせ、企業ごとの用途や予算に合わせた最適なローカルLLM環境を構築可能です。
※資料ダウンロード
お問合せ先
関連ページ
ローカルLLMとRAGを構築してみた【ローカルAI基盤】
人事担当が社内チャットボットの構築を手伝ってみた
Docker×SlurmでGPUを最大活用!ローカルLLM効率化を検証
この記事を書いた人
株式会社トゥモロー・ネット
トゥモロー・ネットは、AI基盤向けインフラの設計・構築・運用を支援しています。GPUサーバーの導入実績1,200台以上、 保守実績66,000台以上の知見をもとに、システム全体の性能や運用性を考慮した提案を行っています。
NVIDIAの最上位パートナープログラム「NVIDIA Elite Partner」に認定され、Supermicro正規一次代理店として10年以上にわたりAIインフラ分野を支援しています。
本サイトのコンテンツは、NVIDIA認定技術者および専門エンジニアを含む技術チームが執筆・監修しています。