

GPUサーバーとは?
GPUサーバーとは、NVIDIA等のGPUを搭載したサーバーです。AI学習・推論、3Dレンダリング、科学技術計算など大量の並列処理が必要な用途に活用されます。従来の汎用的サーバーとは異なり、数千〜数万のコアによる並列演算が可能で、ディープラーニングや生成AIの開発・運用に欠かせないインフラ基盤です。
主な用途

AI・機械学習
LLMや画像生成AIの学習・推論処理を高速化。大規模モデルのトレーニングにも対応します。

科学技術計算・シミュレーション
ゲノム解析・流体力学・構造解析など膨大な計算を高速処理します。

VDI・3Dレンダリング
仮想デスクトップ基盤や3D制作・映像制作環境の構築に最適です。
こんな課題を解決
01
AI・機械学習の開発遅延
LLMやディープラーニングの学習に必要な膨大な行列演算を、GPUの並列処理で劇的に短縮できます。CPUで数時間かかる処理が数分~数秒に。
02
クリエイティブ制作における制作効率の低下
4K/8K動画編集・VFX・3DCGのレンダリングをGPUアクセラレーションで高速化し、クリエイターの制作サイクルを改善できます。
03
ビッグデータ解析・科学技術計算の処理能力不足
気象予測・創薬シミュレーション・金融リスク計算など、複雑な数理モデルの処理をGPUの超並列演算で大幅に高速化できます。
04
高性能計算リソースへのアクセス障壁
自社導入には冷却・電源設備への巨額投資が必要ですが、クラウド型GPUサーバー(IaaS)を利用することで初期投資を抑えつつ必要な時だけ高性能リソースを活用できます。
取り扱いNVIDIA GPU搭載サーバー製品
B300 / B200 / H200 / RTX PRO 2000 Blackwell / RTX PRO 6000 Blackwell 搭載サーバーを取り扱っています。100を超えるラインナップから、用途・予算に最適な構成をご提案します。
NVIDIA B300搭載サーバー

NVIDIA B300搭載 SYS-822GS-NB3RT
| サーバー型番 | SYS-822GS-NB3RT / 8U ラックマウント |
|---|---|
| CPU | Intel Xeon 6767P 64Core 2.4GHz ×2 Intel Xeon 6 processors Granite Rapids |
| GPU | NVIDIA HGX B300 8GPU 280GB HBM3e |
| メモリ | DDR5-6400 ECC REG DIMM 96GB×32 / Total 3,072GB |
| NVMe | M.2 NVMe SSD 1.9TB ×2 / E1.S NVMe SSD 7.68TB ×8 |
| 電源 | 6600W ×6 冗長電源(3+3)/ Titanium Level(96%) |
| ネットワーク | NIC:8ポート NVIDIA ConnectX-8 OSFP 800GbE |
NVIDIA RTX PRO 6000 Server Edition搭載サーバー

NVIDIA RTX PRO 6000 Server Edition搭載 SYS-522GA-NRT
| サーバー型番 | SYS-522GA-NRT / 5U ラックマウント |
|---|---|
| CPU | Intel Xeon 6952P 96Core 2.1GHz ×2 Intel Xeon 6 processors Granite Rapids |
| GPU | NVIDIA RTX PRO 6000 Server Edition 96GB ×8 |
| メモリ | DDR5-6400 ECC REG DIMM 96GB×16 / Total 1,536GB |
| NVMe | 2.5″ U.2 NVMe 1.92TB ×2 2.5″ U.2 NVMe 7.68TB ×8 |
| 電源 | 2700W ×6 冗長電源 / Titanium Level(96%) |
| ネットワーク | NIC:2ポート 10GbE with Intel X710-AT2 RJ45 |
RTX PRO 6000 Max-Q workstation搭載サーバー

RTX PRO 6000 Max-Q workstation
| サーバー型番 | AS -531AW-TC / タワー型 |
|---|---|
| CPU | AMD Threadripper 9970X, UP 32C/64T 4.0G 128MB 350W ×1 |
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q WS Ver.(300W)×2 |
| メモリ | 32GB DDR5 RDIMM 6400 ECC REG ×2 |
| SSD | M.2 NVMe PCIe4 960GB 1DWPD ×2 |
| 電源 | 1300W 冗長電源 Platinum Level |
| ネットワーク | NIC:2ポート 10GbE with Broadcom BCM57416 RJ45 |
NVIDIA RTX PRO 2000 Blackwell搭載サーバー
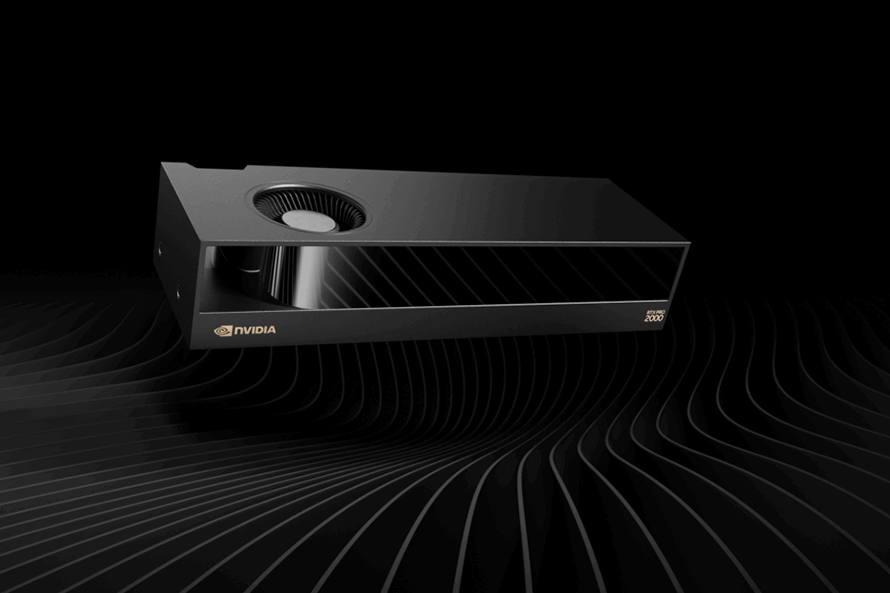
NVIDIA RTX PRO 2000 Blackwell
| サーバー型番 | SYS-741GE-TNRT / タワー型 |
|---|---|
| CPU | Intel EMR 6526Y 2P 16C 2.8G 195W×2 |
| GPU | NVIDIA RTX PRO 2000 Blackwell 16GB×2 |
| メモリ | 2.5″ NVMe 960GB 1DWPD×2 |
| 電源 | 2000W 冗長電源 / Titanium Level |
| ネットワーク | 2ポート 10GbE with Intel X550-AT2 |
※ H100 / B200 / RTX PRO 6000 Blackwell 搭載モデルも取り扱っています。
用途別・GPUサーバーの選び方
GPUサーバーの性能はGPU単体だけでなく、用途・接続方式・周辺スペックによって大きく変わります。3つのポイントを整理し、最適なモデルをお選びください。
用途別おすすめモデル
AI大規模学習向け
B300 / B200
SXM接続・大容量HBMメモリで超高スループットを実現。LLM学習・大規模モデル開発に最適です。
AI推論・ファインチューニング向け
RTX PRO 6000 / L40S
コストと性能のバランスが良く、推論・中規模LLMのファインチューニングに適しています。
PoC・スモールスタート向け
RTX PRO 6000 Max-Q / NVIDIA DGX Spark
オフィス設置も可能なコンパクト構成。小さく始めて段階的に拡張できます。
クラウドとオンプレミスの選び方
クラウドとオンプレミスは、利用期間・処理量・費用・セキュリティ要件で比較します。
クラウドは、短期間の検証や、必要に応じて計算資源を増減したい場合に適しています。オンプレミスは、継続的に高い稼働率で利用する場合や、データの管理・構成の自由度を重視する場合に候補となります。
費用は初期費用だけでなく、利用料や電気代、保守費用を含めた総保有コスト(TCO)で判断します。
接続方式の選び方(PCIe vs SXM)
| PCIe | SXM | |
|---|---|---|
| コスト | 低い | 高い |
| パフォーマンス | 汎用的・環境依存 | AI/HPC特化で最大性能 |
| 主な用途 | 幅広い用途に対応 | 大規模AI学習・HPC |
| トゥモロー・ネット推奨 | — | SXM+Supermicro構成を提供 |
GPUサーバー導入の流れ
01
ヒアリング
要件・用途・予算を確認します。
02
構成・価格提案
最適な構成と価格を提示します。
03
事前検証
エージング・構成確認に対応します。
04
納品作業
ケーブリング・起動確認まで行います。
05
保守・サポート
24時間365日の対応も可能です。
トゥモロー・ネットが提供するGPUの強み
01
NVIDIA Elite Partner だから実現できる、品質と供給力
NPN最上位のNVIDIA Elite Partnerとして、最新GPU(B300 / B200 / RTX PRO 6000 Blackwell等)を優先調達ルートで安定確保。品薄状況でも納期に強く、100を超える豊富なラインナップから用途・予算に最適なGPUを選定できます。NPN Partner Award 2023 Rising Star Award受賞が品質の証です。
02
選定・検証・導入・保守まで、一社完結で安心
GPU選定の相談から、事前検証・カスタム構成・エージング・ラッキング・運用保守まで、すべてトゥモロー・ネット一社で対応。複数ベンダーをまたぐ手間・リスクがなく、導入後も同じ窓口でサポートが受けられます。
1,300台+
GPUサーバー導入実績
68,000台+
保守累計実績
3,000台+
年間出荷台数
03
AI・HPC領域に精通した技術者が、最適解を提案
NVIDIA AI Enterprise対応の専門技術者が在籍し、LLM学習・推論・科学技術計算など用途別に最適なGPU構成を提案。PCIe/SXMの接続方式選定や、ソフトウェア環境構築まで深い技術サポートを提供するため、「買って終わり」ではなく、導入効果を最大化できます。
保守・サポート体制
GPUサーバーの導入後も、トゥモロー・ネットが一貫してサポートします。納品前の品質管理から導入後の運用保守まで、安心してお任せください。
納入時サポート
出荷前に熟練技術者が5つの工程で品質を確認。納品後すぐに本番運用できる状態でお届けします。
- 検査書作成・構成確認
- 最大12時間エージング
- 初期出荷設定(HW/SW)
- 開梱・ラッキング・ケーブリング
- 起動確認・お客様引き渡し
ハードウェア保守
故障時に迅速対応。受付方法・対応時間・修理体制をお客様の要件に合わせてカスタマイズできます。
- オンサイト修理・センドバック対応
- 良品先出し対応も可能
- 電話・メール/24時間365日対応
- 専用倉庫に保守部材を完備
- 豊富なスキルを持つ技術者が迅速に対応
事前検証サポート
導入前にお客様の環境で実際に動作検証。事前検証で課題を解決し、安心して本番導入できます。
- エージング・構成確認対応
- アプリケーション動作検証
- 性能・消費電力の事前測定
- 導入後のシステムモニタリング
- 仮想基盤・ストレージ・NWまで対応
よくあるご質問
海外に設置する場合も購入はできますか?
納品・設置先は日本国内限定となっております。
納期の目安はどのくらいですか?
構成・在庫状況により異なります。NVIDIA Elite Partnerとして優先調達ルートを確保しているため、品薄の状況でも柔軟に対応可能です。まずはご相談ください。
NVIDIA認定サーバーですか?
はい。NVIDIA認定済みのGPUサーバーを提供しています。
スペックのカスタマイズは可能ですか?
はい。CPU・メモリ・ストレージ・ネットワークなどを細かくカスタマイズ可能です。まずはご希望をお聞かせください。また、UPSやネットワークスイッチなどの周辺機器もご相談可能です。
200V環境がない場合はどうすればいいですか?
高性能GPUサーバーはAC200V環境が必要です。電源・空調・設置環境のご相談も承りますのでお気軽にお問い合わせください。