
NVIDIA Blackwellとは?H100比で推論30倍、TCOを25倍削減する次世代AI GPU
NVIDIA Blackwell(ブラックウェル)は、Hopperの後継として登場した、生成AIや大規模言語モデル(LLM)の学習・推論を高速化するGPUアーキテクチャです。Blackwellを採用したシステムでは、H100世代と比べてAI推論性能や電力効率の大幅な向上が図られており、大規模AI基盤からワークステーションまで幅広い用途で活用が進んでいます。
本記事では、Blackwellの特徴やアーキテクチャの進化、H100との性能差、B200・GB200・RTX PRO Blackwellシリーズなどの主な搭載製品、導入時に確認しておきたいポイントまで分かりやすく解説します。
目次
Blackwellとは?NVIDIAが描く次世代AIプラットフォームの核心
ここでは、Blackwellの仕組みや特徴について解説します。
Blackwellアーキテクチャの特徴と進化のポイント
Blackwellは、NVIDIAが開発した次世代AI向けGPUアーキテクチャで、Hopperの後継として2024年に発表されました。
その名は、統計学とゲーム理論に大きな功績を残した数学者、デイヴィッド・ブラックウェル氏に由来します。Blackwellの設計には6つの主要な革新技術が含まれており、AI処理の高速化と効率化を強力に支えています。
注目すべきは、FP4/FP6精度に対応する第2世代Transformer Engineで、大規模言語モデル(LLM)などの推論処理が格段に高速化されました。さらに、RASエンジンの搭載により、障害予兆検出や運用時の安定性も強化。
解凍エンジンによってGPU内部でのデータ展開速度も大幅に向上し、最大800GB/sの解凍帯域を実現しています。これらに加えて、1.8TB/sの帯域を誇る第5世代NVLinkや、省電力制御によるエネルギー最適化も組み込まれているのが特徴です。Blackwellは性能・信頼性・効率の三要素をバランスよく備えた、AI時代の中核アーキテクチャです。
Blackwell・B200・GB200・RTX PROの違い
Blackwellについて調べる際に混同しやすいのが、「Blackwell」「B200」「GB200」「RTX PRO Blackwell」の違いです。
Blackwellは個別のGPU製品名ではなく、NVIDIAが開発したGPUアーキテクチャの名称です。このBlackwellアーキテクチャをベースに、用途の異なるさまざまなGPUやシステムが展開されています。
| 名称 | 位置づけ | 主な用途 |
|---|---|---|
| Blackwell | GPUアーキテクチャ | 各Blackwell製品の基盤技術 |
| B200 | Blackwell搭載データセンターGPU | 大規模AI学習・推論、HPC |
| GB200 | Grace CPUとBlackwell GPUを統合したSuperchip | 大規模LLM、AIファクトリー |
| GB200 NVL72 | GB200をラックスケールで構成したシステム | 超大規模LLM学習・推論 |
| RTX PRO Blackwell | プロフェッショナル向けGPUシリーズ | ローカルAI、AI開発、3DCG、CAD、映像制作 |
このように、B200やGB200は大規模なデータセンター・AIインフラを中心とした製品である一方、RTX PRO BlackwellシリーズはワークステーションやGPUサーバーでのAI開発、設計、クリエイティブ用途など幅広い業務への導入を想定しています。
NVIDIA公式でもBlackwellは2080億トランジスタ、第2世代Transformer Engine、第5世代NVLinkなどを特徴とするアーキテクチャとして位置づけられています。
AIモデル推論性能はH100の30倍|TCOも劇的削減
Blackwellアーキテクチャを搭載したGPUは、AI推論性能においてH100の最大30倍に達するとNVIDIAは発表しています。この飛躍的な性能向上は、FP4演算や新たなメモリアーキテクチャ、高速インターコネクト技術によって実現されました。とくに、Grace CPUとBlackwell GPUを統合した構成では、処理速度とメモリ帯域の両面で効率が大幅に高まります。
代表例として、GB200 NVL72システムはBlackwell GPUを72基、Grace CPUを36基搭載し、最大1.4エクサフロップスのAI処理能力と30TBのメモリ統合空間を備えます。これにより、大規模LLMを一つのGPUのように扱うことが可能となり、従来構成に比べて大幅な性能向上と運用効率を実現しました。
また、同条件下でのTCO(総所有コスト)は従来の25分の1に削減されるという試算もあり、エネルギー消費と設備投資の両方で企業にとって大きなメリットとなっています。Blackwellは、高性能とコスト削減を両立した次世代のAIインフラとしての地位を確立しつつあるといえるでしょう。
クラウドからオンプレまで広がる採用実績と注目度
Blackwellの登場は、クラウドサービスプロバイダーとエンタープライズ市場の双方で大きな反響を呼んでいます。
NVIDIAは、Amazon Web Services(AWS)、Google Cloud、Microsoft Azure、Oracle Cloudといった主要クラウド事業者がBlackwell搭載の新インスタンスを展開すると発表しました。これにより、利用者は従来のクラウド環境のまま次世代AI性能を手軽に享受できるようになります。
一方、オンプレミス環境でもBlackwellの採用は拡大しています。Cisco、HPE、Supermicroなどの主要サーバーメーカーがBlackwell搭載のハードウェア製品を開発・提供しており、企業のAI研究や業務利用への導入が進行中です。
また、AI性能の国際ベンチマーク「MLPerf Inference」でも、Blackwellを搭載したシステムが複数社からエントリーし、競合製品に比べて優れた処理能力を示しました。
このように、Blackwellはクラウドとオンプレミスの両方の領域において急速に普及しており、次世代AIインフラのスタンダードとして、業界の中心的な存在になりつつあります。
Blackwell搭載製品まとめ|B200・GB200・RTX PROシリーズを紹介
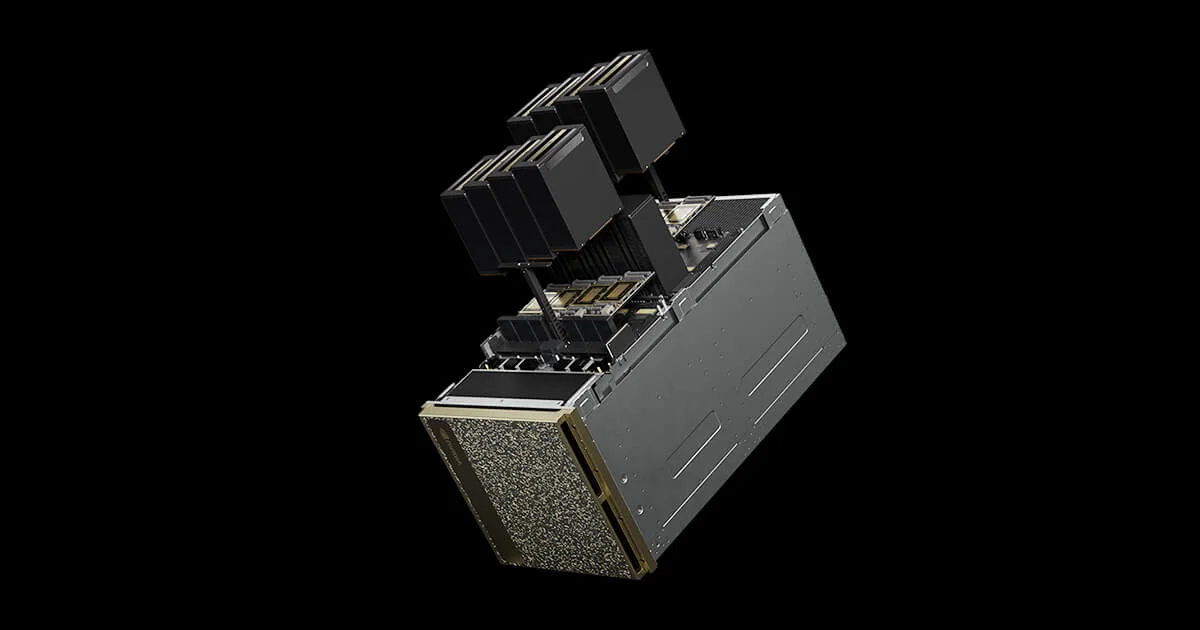
ここでは、Blackwellが搭載されている製品を解説します。
B200 TensorコアGPU
B200は、NVIDIAのBlackwellアーキテクチャを採用した最新のAI向けGPUで、推論処理に最適化された中核モデルです。
2080億のトランジスタを搭載し、第2世代のTransformer EngineによってFP4やFP6の低精度演算に対応しながら、処理の高速化と省電力化を両立しています。さらに、次世代NVLinkは1.8TB/sの帯域を誇り、GPU間の通信遅延を大幅に低減。
HGX B200構成では最大8基のGPUを連携させ、スケーラブルに運用可能です。Supermicroなどからは、これを活用した高密度AIサーバーが提供されており、H100比で最大15倍の推論性能を達成しています。B200は、汎用性と性能のバランスに優れたAI時代の主力GPUといえるでしょう。
GB200 Grace Blackwell Superchip
GB200は、2基のB200 GPUと1基のGrace CPUを高速接続で統合した、NVIDIAの次世代スーパーコンピューティングチップです。この「スーパーチップ」は、最大900GB/sの通信帯域を実現し、CPUとGPUのデータやり取りのボトルネックを解消します。
LLM推論では、H100構成と比べて最大30倍の性能向上、学習では約4倍の効率化が期待されています。Grace CPUは高効率なArmベース設計により、処理性能を維持しつつ消費電力を抑える設計となっており、TCO削減にも貢献するのが特徴です。
GB200は、パフォーマンスと電力効率の両立を求めるAI処理において、極めて実用的かつ先進的な構成です。
NVL72システムとDGX SuperPOD
NVL72は、72基のBlackwell GPUと36基のGrace CPUを1ラックに統合したラックスケールのAIシステムです。1.4エクサフロップスの演算能力と30TBの統合メモリを活かし、大規模LLM推論を1つのGPUのように実行可能にします。
従来のH100構成と比べ、推論性能は最大30倍、TCOは25分の1にまで圧縮されるとされます。さらに、複数のNVL72を連結して構成されるDGX SuperPODは、企業や研究機関向けにスケーラブルなAIインフラを提供。
すでに各国で採用が進んでおり、AI導入を加速する基盤として注目されています。大規模展開を前提に設計されたこのシステムは、次世代のAI運用を支える柱となるでしょう。
NVIDIA RTX PRO Blackwellシリーズ
NVIDIA Blackwellアーキテクチャは、大規模AI基盤向けのB200やGB200だけでなく、プロフェッショナル向けGPU「NVIDIA RTX PRO Blackwell」シリーズにも採用されています。
RTX PRO Blackwellシリーズは、第5世代TensorコアやGDDR7 ECCメモリなどを搭載し、生成AI・ローカルLLMの学習や推論、3Dレンダリング、CAD・CAE、シミュレーション、映像制作など、幅広いワークロードに対応します。
トゥモロー・ネットでは、RTX PRO 6000からRTX PRO 2000まで用途や必要なGPUメモリ、消費電力に応じた製品を取り扱っています。
| 製品 | GPUメモリ | 特徴・想定用途 |
|---|---|---|
| NVIDIA RTX PRO 6000 Blackwell | 96GB GDDR7 ECC | 大規模AIモデル、AI学習・推論、高度な3D・シミュレーション |
| NVIDIA RTX PRO 5000 Blackwell | 48GB / 72GB GDDR7 ECC | ローカルLLM、AI開発、高度な3DCG・映像制作 |
| NVIDIA RTX PRO 4500 Blackwell | 32GB GDDR7 ECC | AI推論、CAD・CAE、3D、シミュレーション |
| NVIDIA RTX PRO 4000 Blackwell | 24GB GDDR7 ECC | AI開発、3D設計、映像制作、省スペース環境 |
| NVIDIA RTX PRO 2000 Blackwell | 16GB GDDR7 ECC | ローカルAI、PoC、CAD、省電力ワークステーション |
RTX PRO 6000 Blackwellは96GBのGDDR7 ECCメモリを備え、AIトレーニング・推論やシミュレーション、高度な3D処理などを想定しています。Server Edition、Workstation Edition、Max-Q Workstation Editionが用意されています。
RTX PRO 5000 Blackwellは48GBまたは72GBのGDDR7 ECCメモリを搭載し、MIGによるGPUリソースの分割にも対応しています。複数ユーザーでの利用やローカルLLMなど、大容量GPUメモリを必要とする環境にも適しています。
RTX PRO 4500 Blackwellは32GBのGDDR7 ECCメモリを搭載し、Server EditionとWorkstation Editionを選択できます。AI処理と3Dグラフィックス、CAD・CAEなどをバランスよく処理したい場合の選択肢となります。
RTX PRO 4000 Blackwellは24GBのGDDR7 ECCメモリを搭載し、フルサイズモデルに加えてSFF Editionもラインアップされています。SFF Editionは70Wの省電力設計となっており、省スペース環境でのAI・グラフィックス処理にも対応できます。
RTX PRO 2000 Blackwellは16GBのGDDR7 ECCメモリを搭載し、消費電力は70Wです。ローカルAIの検証やAIアプリケーション開発、CADなど、比較的コンパクトな環境からBlackwell世代のGPUを導入したい場合に適しています。
Blackwell導入時の注意点を追加
製品紹介の後、まとめへ行く前に新規H2として追加することを推奨します。
Blackwell搭載GPUを導入する際のポイント
Blackwell搭載GPUの性能を十分に引き出すには、GPU単体のスペックだけでなく、サーバーやワークステーション全体の構成を考える必要があります。
GPUメモリ容量を用途に合わせて選ぶ
LLMや生成AIでは、モデルサイズや量子化方式、コンテキスト長などによって必要なGPUメモリ容量が変化します。GPUを選定する際は、現在使用するモデルだけではなく、将来的なモデルの大型化も踏まえて余裕のある構成を検討することが重要です。
電力・冷却要件を確認する
Blackwell搭載GPUは製品によって消費電力が大きく異なります。例えばRTX PRO 2000 Blackwellは70Wですが、RTX PRO 6000 Blackwell Workstation Editionは600Wとなるため、電源容量や筐体内の冷却性能まで含めた確認が必要です。
GB200 NVL72のような大規模システムでは液冷を前提としており、GPUだけではなくデータセンター側の電源・冷却設備まで含めた設計が必要になります。
ストレージ・ネットワークも含めて設計する
AI学習や大規模推論では、GPU性能が高くてもデータ供給が追いつかなければGPUを十分に活用できません。大量の学習データを高速に読み込めるストレージや、複数GPU・複数ノード間を低遅延で接続できるネットワークなど、AI基盤全体でボトルネックが発生しない構成にすることが重要です。
InfiniBand(インフィニバンド)とは?Ethernet(イーサネット)との違いも解説
まとめ
NVIDIA Blackwellの登場により、AIインフラはさらなる性能向上と省エネルギー化を実現し、業界全体に革新をもたらしています。しかし、その真価を引き出すには、GPUだけでなく、サーバーやストレージ、ネットワークまで含めた全体のインフラ最適化が不可欠です。
株式会社トゥモロー・ネットでは、AI導入における設計・構築・運用支援までを一貫して提供しています。用途に応じた高性能GPUサーバー、堅牢なストレージ、低遅延ネットワークを組み合わせた最適なAI基盤を構築可能です。
詳細なご相談やお見積もりについては、ぜひお気軽にお問い合わせください。
※資料ダウンロード
お問合せ先
関連ページ
NVIDIA B200とは?DGX B200とHGX B200の違いを解説
LLMとGPUの関係とは?LLMに必要なGPUのスペックも解説
NVIDIAエンタープライズ向けGPUの種類とスペックを徹底比較
この記事を書いた人
株式会社トゥモロー・ネット
トゥモロー・ネットは、AI基盤向けインフラの設計・構築・運用を支援しています。GPUサーバーの導入実績1,200台以上、 保守実績66,000台以上の知見をもとに、システム全体の性能や運用性を考慮した提案を行っています。
NVIDIAの最上位パートナープログラム「NVIDIA Elite Partner」に認定され、Supermicro正規一次代理店として10年以上にわたりAIインフラ分野を支援しています。
本サイトのコンテンツは、NVIDIA認定技術者および専門エンジニアを含む技術チームが執筆・監修しています。