
Kubernetes × AI|GPU搭載オンプレ環境での機械学習基盤構築ガイド【トゥモロー・ネット テックブログ】
AI(人工知能)のビジネス活用や大規模なディープラーニングの取り組みが本格化する中で、モデルの開発から本番運用までの一連のサイクル(MLOps)を支える基盤づくりが急務となっています。
その中核として、コンテナ管理を自動化するKubernetesの導入が拡大しています。しかし、コンテナ層と物理ハードウェア層の複雑な連携により、期待通りの性能が出ないといった問題に直面することも少なくありません。
本記事では、Kubernetesを用いたAI基盤のメリットと、オンプレミス環境で直面する性能の壁、そして失敗しない構築基準を解説します。
目次
KubernetesをAI・機械学習(MLOps)基盤に導入するメリットと直面する性能の壁
Kubernetesはコンテナの自動運用を可能にし、柔軟なMLOps基盤の構築を強力に支えるツールです。
しかし、オンプレミスのGPU環境でそのメリットを最大化するためには、物理インフラとコンテナネットワークの複雑な関係性を深く理解しなければなりません。
まずは導入の利点と、分散学習で陥りがちな課題について解説します。
Kubernetesとは?コンテナオーケストレーションの仕組みとメリットを解説
AI開発・MLOpsでKubernetes(K8s)が標準技術として選ばれる理由
Kubernetesは、コンテナ化されたアプリケーションの配備やスケーリングを自動化するコンテナオーケストレーションツールであり、実験の再現性やリソースの効率的な分配が求められるAI開発において有効です。
複数個のコンテナからなる複雑なMLパイプラインを一元管理し、リソースのスケジューリングを自動化できるため、現代のMLOps基盤のデファクトスタンダードとなっています。
例えば、大量のデータを扱う学習ジョブが動く際、必要なタイミングで動的にGPUやCPUリソースを割り当て、完了後に自動で解放するといった高度な制御が可能です。
これにより、チーム内でのリソース競合を防ぎつつ、ハードウェアの稼働率を極限まで高めて効率的なAI開発のワークフローを実現できます。
オンプレミス環境にGPU搭載Kubernetesクラスターを構築する利点
機密性の高いデータを扱うAI開発においては、パブリッククラウドではなくオンプレミス環境にGPU搭載のKubernetesクラスターを構築する企業が増えています。
オンプレミスであれば、データ転送コストや長期的なコンピューティングコストを抑えつつ、物理ハードウェアのポテンシャルを最大限に活かしたセキュアな専用AIプラットフォームを柔軟に設計することが可能です。
クラウドのようにデータ利用量に応じた従量課金やネットワークの遅延を気にする必要がなく、自社の資産としてフル活用できます。
また、独自のネットワークトポロジーを組むことで、データガバナンスとインフラのカスタマイズ性を両立させながら、安全かつ高速な機械学習環境を維持できる点が大きなメリットです。
期待通りのパフォーマンスが出ない?コンテナ分散学習における通信オーバーヘッドの罠
Kubernetes上で複数ノードを跨いだ分散学習を実行する際、コンテナの仮想ネットワーク層や物理ハードウェア間の通信オーバーヘッドがボトルネックとなり、想定通りの学習速度が出ないという課題が頻出します。
ハードウェアの特性を考慮せずにPod(ポッド)*をスケジュールすると、システム全体の不整合が原因で処理効率が著しく低下してしまいます。
具体的には、学習プロセス間で頻繁に行われるグラディエント(勾配)の同期通信が、仮想ネットワークのパケット処理遅延によって停滞するケースです。
どれほど最先端のGPUを採用していても、コンテナ層と物理ネットワークの連携が最適化されていなければデータ供給が追いつかず、投資に見合った分散学習の恩恵を受けられなくなります。
*Kubernetesでアプリを動かす最小単位、アプリを実行・管理するための入れ物
Kubernetes×GPU環境の処理が遅くなる原因は?
コンテナクラスター環境における処理の停滞は、Kubernetesの管理機能と物理ハードウェアのトポロジーがうまく噛み合っていないことから発生します。
高価なGPUリソースを無駄にしないために、NUMA構成、ネットワークインターコネクト、そして見落とされがちなホストCPUの性能不足という、インフラ層に潜む3つの具体的な性能低下の原因を詳しく紐解きます。
Podへのリソース割り当てとNUMA構成の不整合によるレイテンシ
マルチソケットCPUを搭載したサーバーでは、メモリとCPUの物理的な配置構造であるNUMAへの配慮が欠かせません。
Kubernetesのkubelet設定やコンテナ側で適切なCPUアフィニティ設定(トポロジーマネージャーの最適化など)が行われていない場合、NUMAノードをまたいだメモリ書き込みが発生し、致命的なレイテンシの増大を招きます。
具体的には、Pod内の学習プロセスが割り当てられたCPUとは物理的に遠い位置にあるメモリを参照してしまい、内部通信のオーバーヘッドが蓄積する現象です。
この不整合は、ディープラーニングのような秒間数万回以上のメモリデータ転送を伴う演算において、顕著な速度低下を引き起こす重大な要因となります。
コンテナ間通信を阻害するPCIeレーン不足とNVLink/InfiniBandの設計不備
GPUとホストCPU間、あるいはGPU間で大量のデータをやり取りする際、マザーボード上のPCIeレーンの帯域幅やアロケーションが最適化されていないと、データ転送に急ブレーキがかかります。
さらに、複数ノードのPod間で同期を行うためのNVLinkやInfiniBandといった高速インターコネクトのトポロジー設計が不十分だと、ネットワークが飽和して分散学習のパフォーマンスが著しく阻害されます。
特にコンテナ環境では、物理的なネットワークカードとPodのネットワーク空間が直結されていないケースが多く、設計不備があるとパケットの転送ロスや遅延が多発するでしょう。通信のボトルネックは、どれだけ高性能なGPUを搭載していても解消できない致命的な弱点となります。
Kubernetesノードの管理とデータ前処理を遅らせる「CPUボトルネック」
AI・機械学習ではGPUの演算性能ばかりが注目されますが、コンテナの制御やパケット処理、膨大なデータの前処理はホストCPUの役割です。
CPUのコア数や動作クロックが不足していると、高価なGPUへデータを供給するスピードが追いつかなくなる「CPUボトルネック」が発生し、結果としてGPUの稼働率を大きく低下させる要因となります。
例えば、Kubernetesクラスターの運用に伴う内部通信や、Pod管理プログラムのオーバーヘッドを処理しながら、並行して画像やテキストの圧縮解凍といった前処理を行うには、CPUに非常に高い負荷がかかります。
CPU性能を妥協すると、高価なGPUがデータ待ちで空転する状態を招いてしまうでしょう。
オンプレミスGPU環境でのKubernetesクラスター構築・選定基準
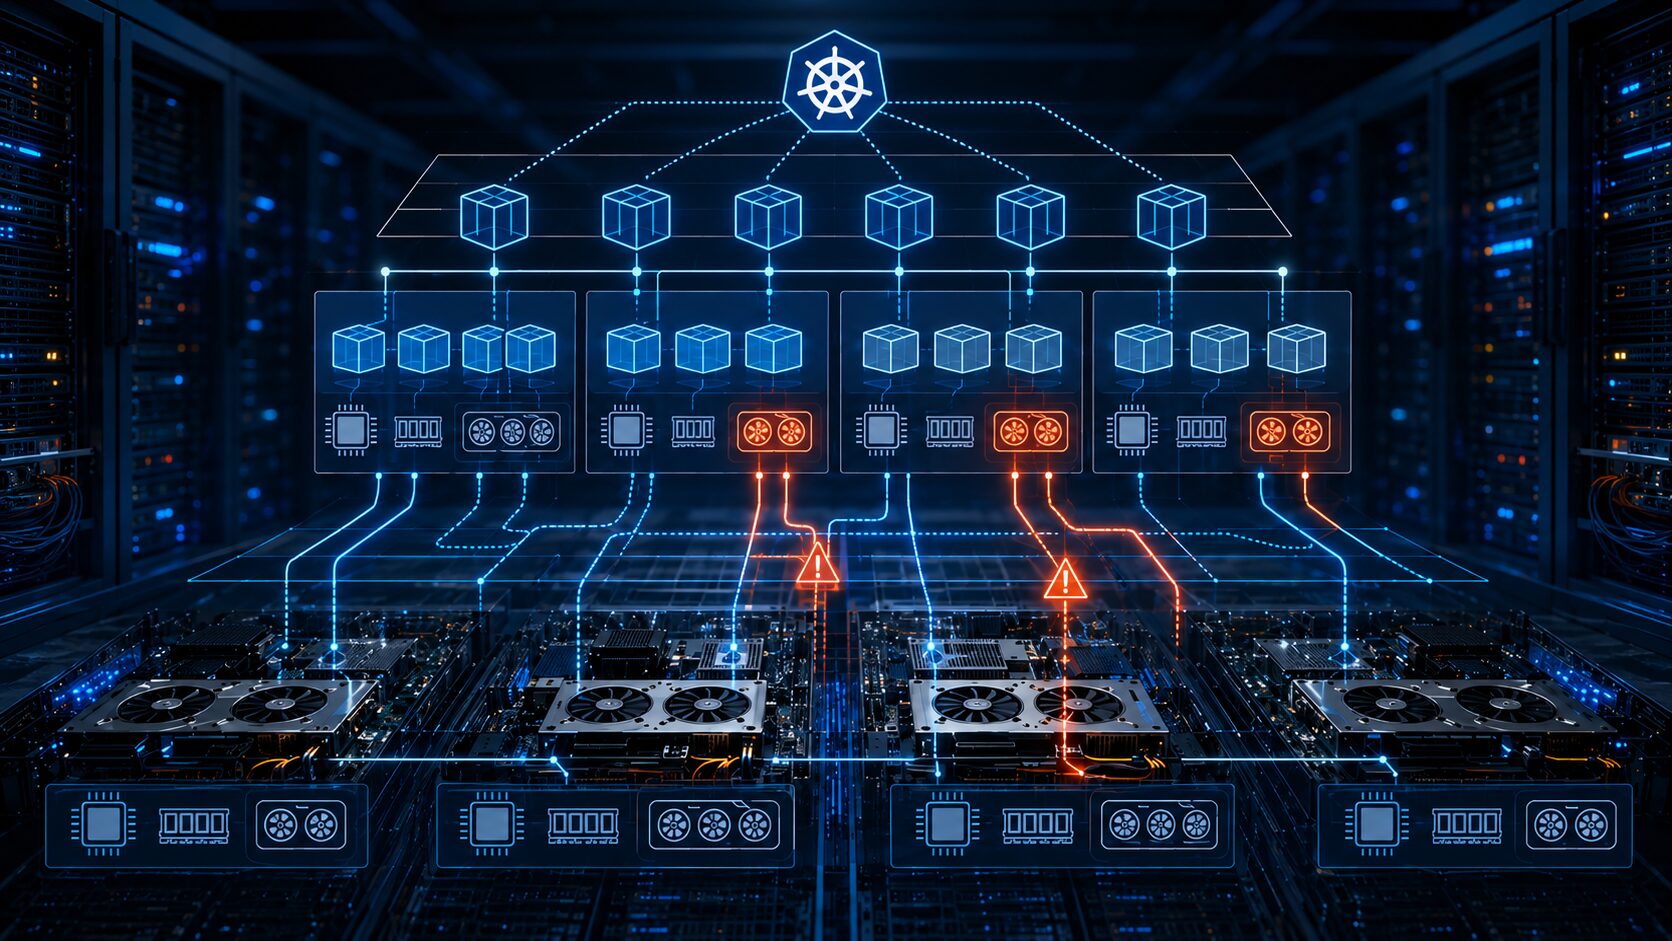
Kubernetesを用いたAIインフラを成功させるには、カタログスペックの比較から脱却し、ハードウェアとオーケストレーションソフトを一体で設計する必要があります。
システム全体を最適化するためのバランス設計の重要性と、それを支えるソフトウェア管理のソリューション、そして自社構築に伴う技術的リスクについて解説します。
カタログスペックの「点」ではなくシステム全体の「線」で見るバランス設計
失敗しない自社GPU基盤の選定では、GPU単体の性能という「点」ではなく、それを支えるCPU、メモリ、ストレージ、高速ネットワークがボトルネックなく連携できる「バランス」が重要です。
AIプラットフォームの多重実行や大規模分散学習に耐えうるよう、ハードウェア層からネットワークトポロジーまでをトータルで設計しなければなりません。
こうした複雑なコンテナインフラを効率的に運用・管理するためには、高度な管理ソフトウェアの活用が不可欠です。
当社では、ハイブリッド環境を一元化するプラットフォームや、AI特化型の高機能コンテナオーケレーターの提供を通じて、インフラ全体の最適なバランス設計をサポートしています。
インフラ管理とコンテナ運用の最適化製品については、下記ページをご覧ください。
クラウド統合管理プラットフォーム「OKESTRO」
コンテナオーケストレーター「Qeek Container Orchestrator」
複雑なK8s×GPUインフラにおける「自社構築」の技術的リスクと限界
ホワイトボックスのパーツを集め、自前でAI用のKubernetesクラスターを構築・チューニングすることには極めて高い技術的リスクが伴います。
ハードウェアのNUMA構造やPCIeレーンの物理配置と、Kubernetes層のリソース割り当てを最適にマッピングするには専門的な知見が必要であり、設計ミスはハードウェアの故障や、性能を出し切れないといったリスクを招くからです。
また、Kubernetes自体や各種プラグイン、GPUドライバのバージョン管理は極めて複雑であり、検証不足の自前環境ではシステムアップデートのたびに動作が崩壊するリスクもあります。
ビジネスにおける開発スピードと安定性を担保するためには、自社構築の試みは早期に限界を迎えてしまうでしょう。
KubernetesによるAI基盤の最適化なら「NVIDIA Elite Partner」のトゥモロー・ネットへ
オンプレミスのGPU搭載Kubernetes環境において、ハードウェアのポテンシャルを限界まで引き出し、安定したMLOps基盤を運用するには専門エンジニアの支援が確実な選択肢です。
最後に、企業の高度なAIプラットフォーム戦略を支える、当社の強みと安心のサポート体制について詳しくご紹介します。
NVIDIA Elite Partnerとしての確かな技術力と圧倒的な調達力
株式会社トゥモロー・ネットは、最上位のパートナー資格である「NVIDIA Elite Partner」に認定されています。
「NPN Partner Award 2023 Rising Star Award」を受賞した実績もあり、NVIDIAの最新GPUや高速インターコネクト製品に対する深い知見とノウハウを有しています。
世界的に需給が逼迫している最新鋭のAIインフラハードウェアにおいても、強固なパートナーシップに基づく高い調達力でお客様の要求に迅速に応えるでしょう。
コンテナ環境においてGPUの能力を余すことなく発揮するためのトポロジー設計から、ネットワークの最適化にいたるまで、確かな技術力を活かしてお客様のビジネスに最適な高性能AI開発環境をスムーズに提供いたします。
Supermicro製品の最適化からKubernetes環境の構築・運用までワンストップサポート
当社はSupermicroの正規一次代理店として、高性能なSupermicro製品をベースに、CPUボトルネックの解消からNUMA構成の最適化、NVLink/InfiniBandの設計までをインフラ全体で最適化して提供します。
Kubernetes環境における複雑なハードウェアアフィニティ設定や、構築後の運用メンテナンス、トラブルシューティングまで専門のエンジニアがワンストップで全面サポートいたします。
AIインフラの設計・構築から運用まで一貫提供できる体制を強みとしており、インフラ構築に伴うあらゆる技術的リスクを排除するのが特徴です。
自社に最適な、安定性とパフォーマンスを兼ね備えたKubernetesによるAI基盤づくりは、トータルサポートが可能な当社にぜひお任せください。
お問合せ先
関連ページ
KubernetesでGPUを活用するメリットとは?コンテナ化によるAI開発効率化
Dockerと仮想マシンの違いは?メリット・デメリットと使い分けを徹底比較
Minikubeとは?Kubernetesをローカルで簡単に試す方法と活用・限界をわかりやすく解説
この記事を書いた人
株式会社トゥモロー・ネット
トゥモロー・ネットは「ITをもとに楽しい未来へつなごう」という経営理念のもと、感動や喜びのある、より良い社会へと導く企業を目指し、最先端のテクノロジーとサステナブルなインフラを提供しています。設立以来培ってきたハードウェア・ソフトウェア製造・販売、運用、保守などインフラに関わる豊富な実績と近年注力するAIサービスのコンサルティング、開発、運用、サポートにより、国内システムインテグレーション市場においてユニークなポジションを確立しています。
インフラからAIサービスまで包括的に提供することで、システム全体の柔軟性、ユーザビリティ、コストの最適化、パフォーマンス向上など、お客様の細かなニーズに沿った提案を行っています。